供儿童制作交互物件原型的 VR 系统
2021年2月
概述
Smart Codesign VR 是一个在虚拟现实中搭建并测试交互式“智能物件”的原型平台。玩家从环境、输入和输出中各选一张卡片,再通过身体动作定义物件何时响应、如何响应。完成的虚拟物件可以放进公园,测试它的行为。
项目以米兰理工大学 i3Lab 开发的桌游 SNaP(The Smart Nature Protagonists)为基础。在 SNaP 中,孩子们组合卡片来构思智能物件,并用一句话把它写在纸上。本项目希望把这些文字描述转化为虚拟物件,让孩子们通过自己的动作组装它们并与之互动。
我们的四人团队为米兰理工大学 2020–21 学年 Advanced User Interfaces 课程的期末项目设计并实现了这一系统。预期使用者为 11 至 13 岁儿童,尤其关注有神经发育障碍(NDD)的儿童。原型面向 Oculus Quest 2,以 Unity 和 C# 开发,支持从卡片选择到虚拟公园中交互的完整流程。
SNaP这款桌游,以及设计的前提
让孩子成为设计主角的游戏
在 SNaP 中,2 至 4 名儿童扮演“设计师”,一名成年主持人扮演“市长”。市长提出任务,孩子们讨论想法、组合卡片,设计能回应任务的智能物件。游戏旨在培养创造力、协作能力和表达想法的能力,也考虑了有神经发育障碍的儿童的使用需求。不过,本项目没有评估治疗或教育效果。
环境、输入、输出——三种卡片
SNaP的卡片有三种,各自承担不同的角色。
环境(Environment)卡表示将被赋予智能的物件:树、长椅、秋千、水域、石头、路灯、垃圾桶、自行车、桥、台阶或书包。这些都是公园和街道中常见的物件或设施。环境卡决定了由哪个物件承载输入与输出功能。
输入(Input)卡定义物件检测什么,或对什么作出响应,例如按钮、动作、接触、距离、温度、湿度、亮度、颜色、声音、火、水位或天气预报。它们表示智能物件的输入功能,作用类似于传感器。
输出(Output)卡定义物件如何响应,例如发光、发声、振动、移动、显示、记录或发送信息。它们表示物件的输出功能,作用类似于执行器。
环境卡为一组输入与输出提供具体情境。例如,输入为动作、输出为声音时,垃圾桶可以在垃圾未投中时发声,路灯则可以提示有人靠近。输入与输出定义设备如何响应,而环境卡把这种行为与日常生活中的情境联系起来。
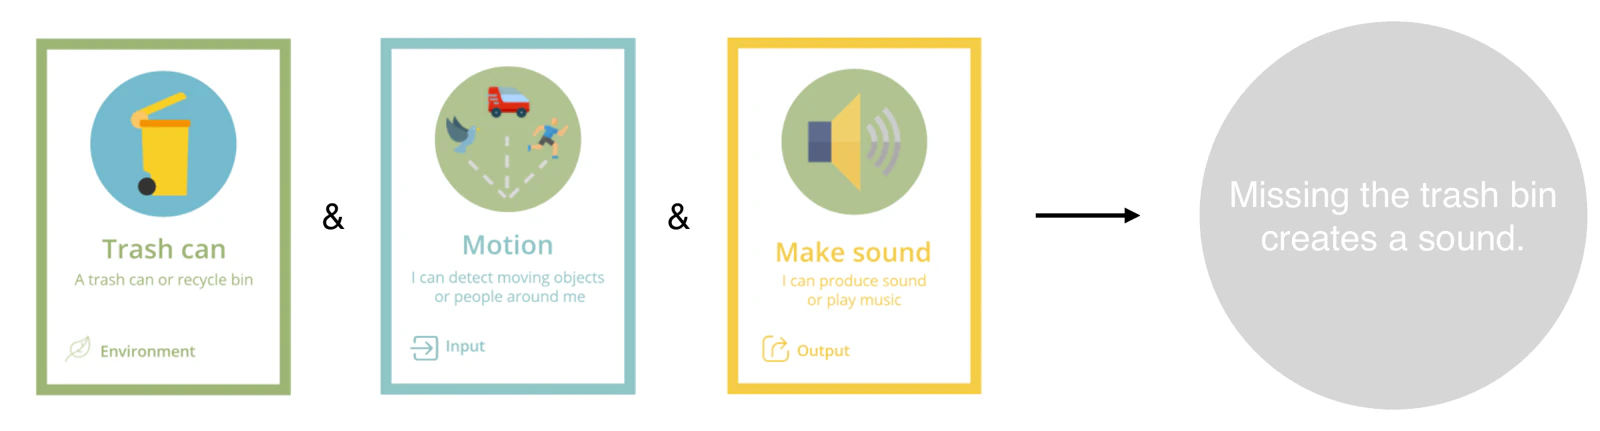
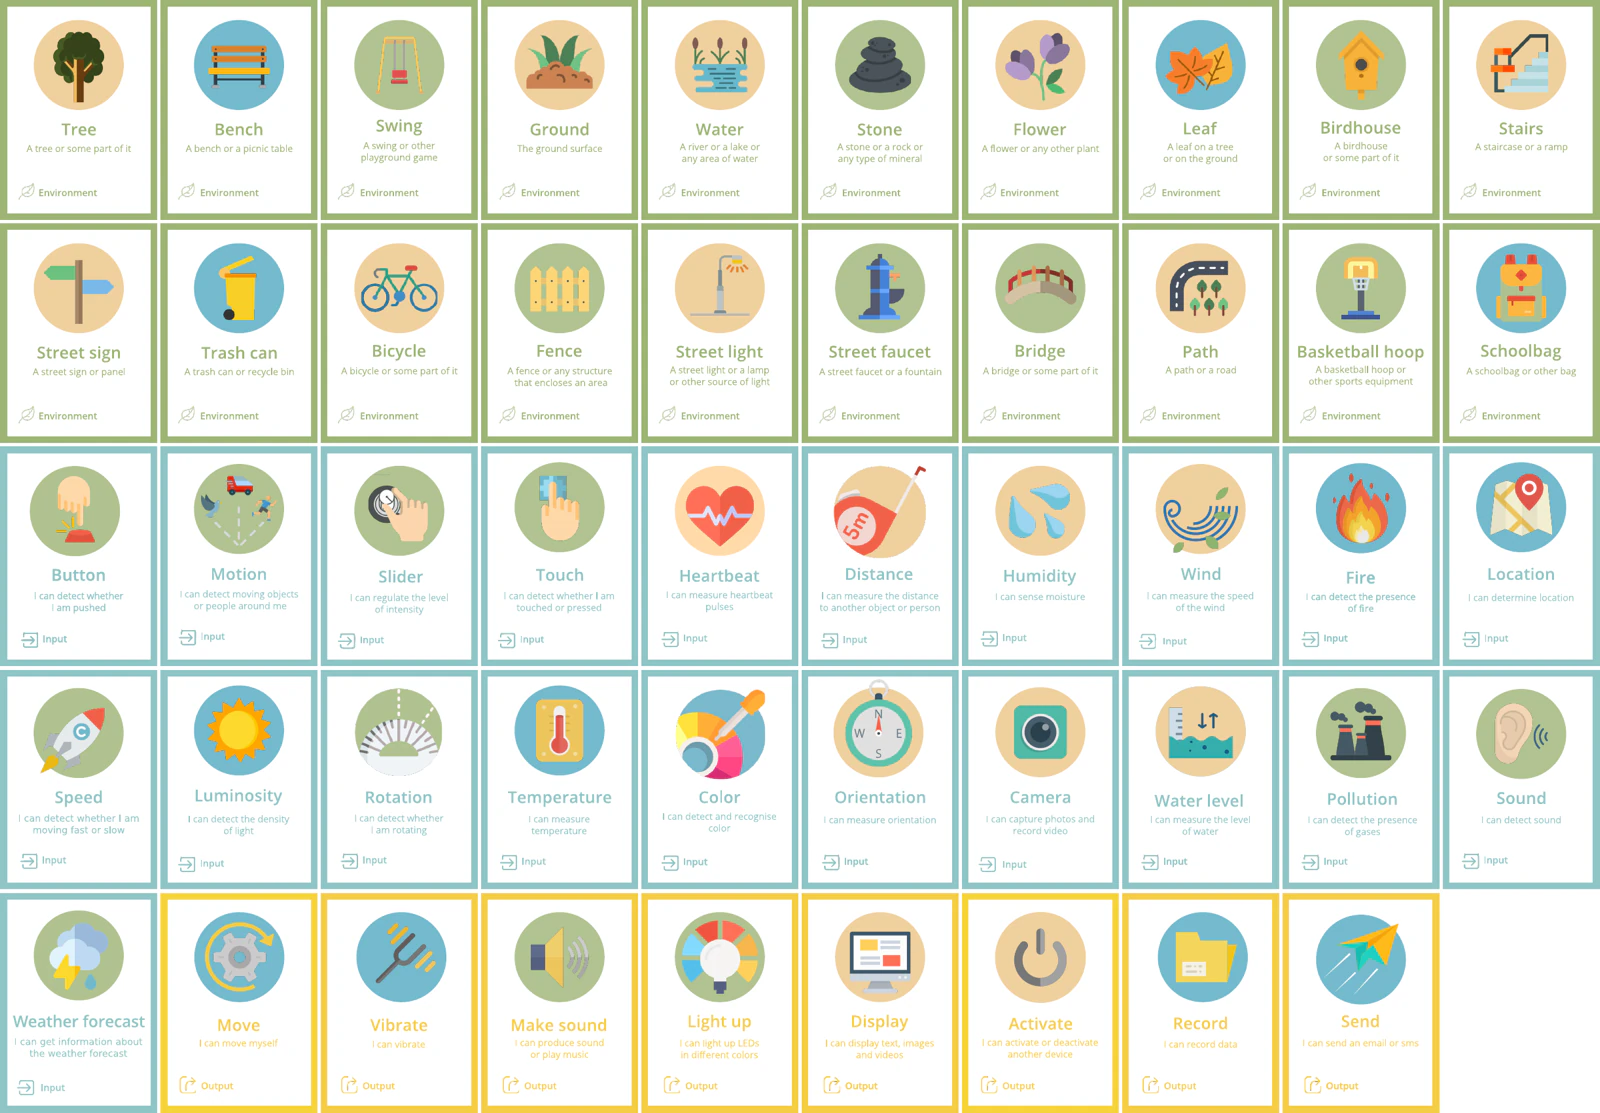
将文字构想转化为可交互的虚拟物件
此前,SNaP的每一场活动都在把构思出的智能物件写成一句话时结束。在i3Lab,还并行开发着把它实际搭建出来的「实体板」,把平板与Arduino结合起来。Smart Codesign VR是对同一个问题的另一个回答,选择了VR作为媒介——这是研究团队当时还没有尝试过的方向。
VR 带来了两种可能。首先,孩子们可以通过全身动作制作原型:抓取、搬运、照光和用画笔涂抹,都可以成为设定条件与定义行为的方式。其次,想法可以呈现为可见的虚拟物件,并立即与之互动。纸上的描述由此变成了眼前具有大小与形状的物件。
为谁而设计
预期使用者为 11 至 13 岁的儿童,尤其关注有神经发育障碍的儿童。设计智能物件需要一定的逻辑推理能力,因此 SNaP 及其 VR 版本都面向这一年龄段。
项目希望通过动手制作原型与交互,帮助孩子表达想法。这些是设计目标,并非已经证实的治疗或教育效果;原型尚未经过儿童用户评估。
对空间本身的考量
根据项目参考的资料,我们从四个方面指导空间设计:声音、光与颜色、空间组织,以及材料。声音方面考虑了隔离噪声、调节音量,以及安静、稳定的音频,以照顾听觉敏感的使用者。光与颜色方面考虑以平静的低饱和色为背景,将明亮、高饱和色限制在小范围内。清晰的空间边界、有序的布局、简单易辨的形态,以及顺畅的通行空间,也都是设计考量。虚拟环境允许设计者控制这些因素,但本项目未评估它们对使用者舒适度的影响。
VR这一媒介本身带有的限制
项目也考虑了 VR 的限制与风险:硬件成本、晕动不适、头显重量给头颈带来的负担、设备遮挡现实环境可能导致的意外、长时间使用造成的眼疲劳,以及过度沉浸带来的依赖方面的担忧。
这些考量形成了三项设计决定:保持交互简单,同时提供足以支持学习的挑战;让视听信息清晰,避免过度刺激;为体验设置明确终点。完成原型制作与公园中的测试后,活动即结束,而非鼓励使用者无限期地停留在 VR 中。
原型:体验流程与实现
体验的四个场景
应用由四个场景构成:待机画面、卡片选择、原型制作,以及在公园中的操作。
1. 待机画面
应用启动后先显示标题画面,等待玩家按下手柄按钮再继续。这一有意设置的停顿,让玩家有时间戴好头显、调整姿势,再进入主要体验。
2. 卡片选择——抓起来,放进箱子
在下一个场景中,从环境、输入、输出各选一张卡片。选择的方式,是抓起代表卡片的物体,搬到对应的箱子里放进去。之所以不用点击而用「抓取并搬运」,是为了利用VR所拥有的三维空间。当检测到三个箱子都有了内容,就会伴随语音提示进入原型制作场景。顺序不限,但三个不填满就无法继续。
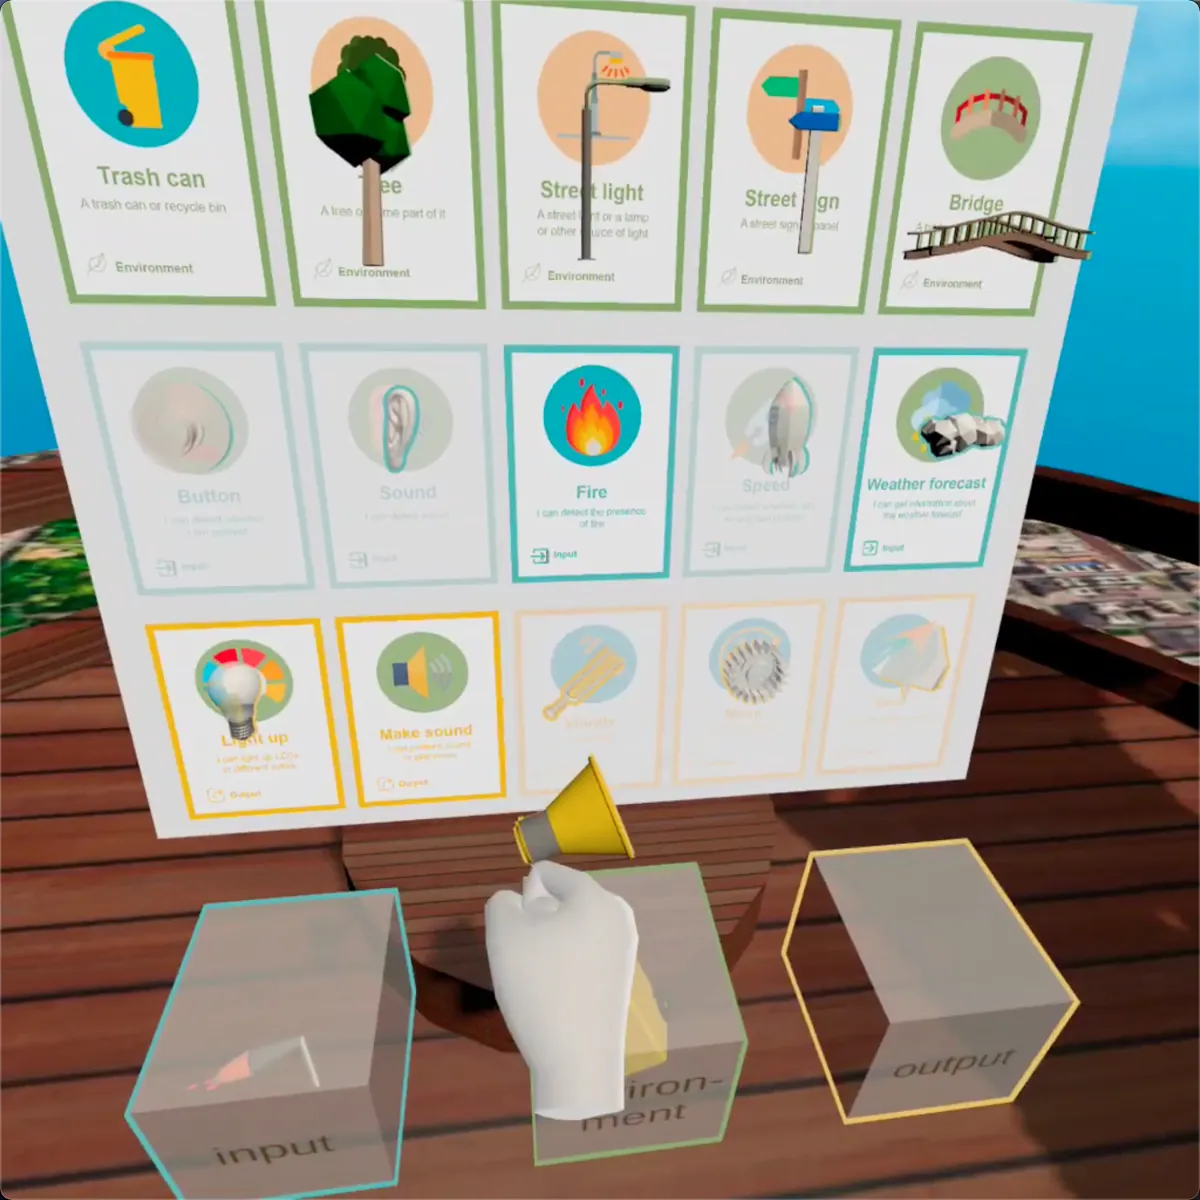
3. 原型制作——用身体决定条件与行为
这里是整个系统的核心。针对选中的输入卡定义「在什么时候」,针对输出卡定义「做什么」。操作方式按卡片分别制作,并且分配了唯有六自由度追踪才能实现的动作。
例如,输入选择「天气预报」时,手边会出现分别代表晴、阴、雨、雷、雪的物体。抓起其中之一,把从它延伸出的光线对准目标物体,条件即告确定。输出选择「发光」时,则抓起画笔,把笔尖浸入各色颜料罐,再涂抹到对象上,以此决定发光的颜色。想擦掉涂上的颜色时,把笔浸入「水」罐再涂一次即可。
在实现上意义重大的一点,是让输入与输出的组合可以并列定义多组。最初的计划只有一组,「晴天就发红光」便到此为止。改为多组之后,一个物件就能对多种情形作出不同的回应,比如「晴天红、下雨蓝、下雪白」。定义好的组在确定之前可以实际运行试一试,不满意还能退回去修改。
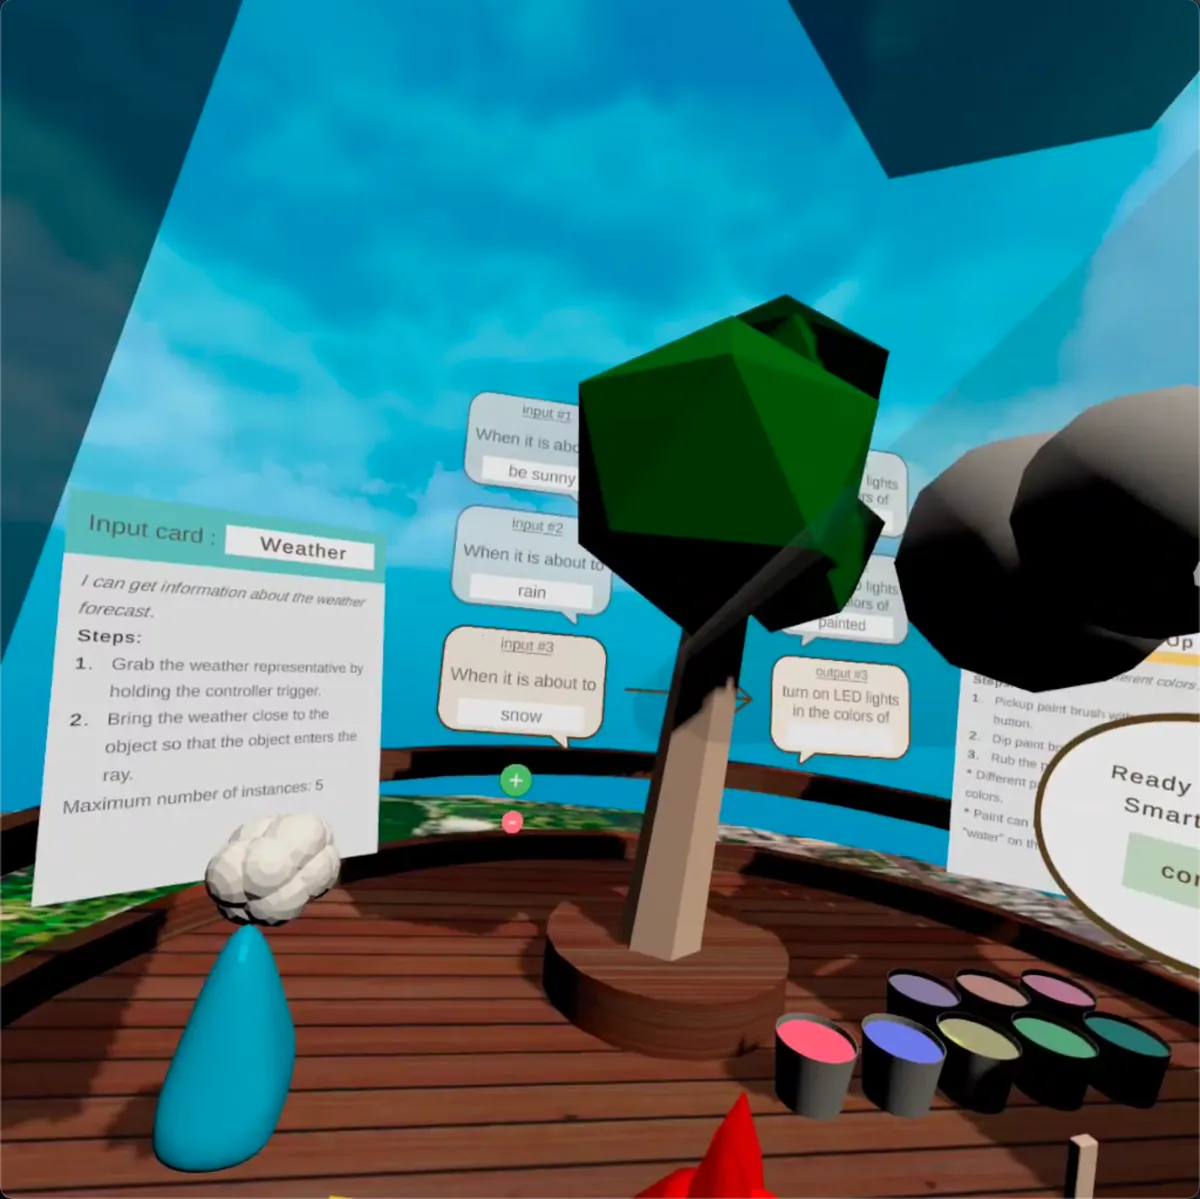
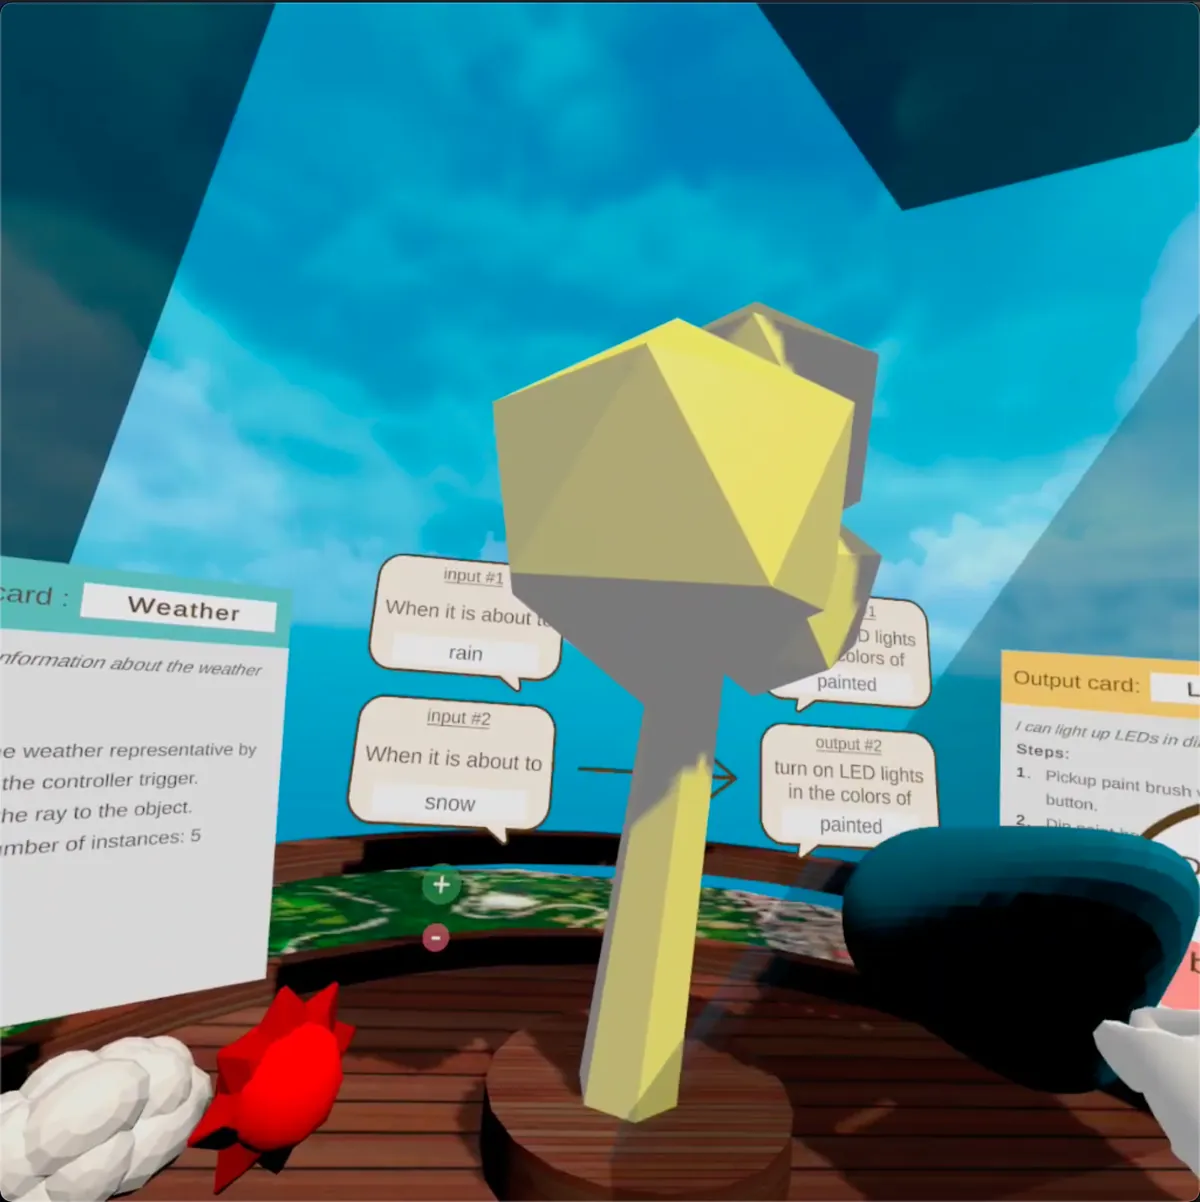
4. 公园:测试物件
确定物件之后,便移动到虚拟公园。在这里放下自己组装的智能物件,触发所定义的输入条件,实际确认输出的行为。物件成功动作之后,会出现庆祝的演出,体验就此结束。
整体流程
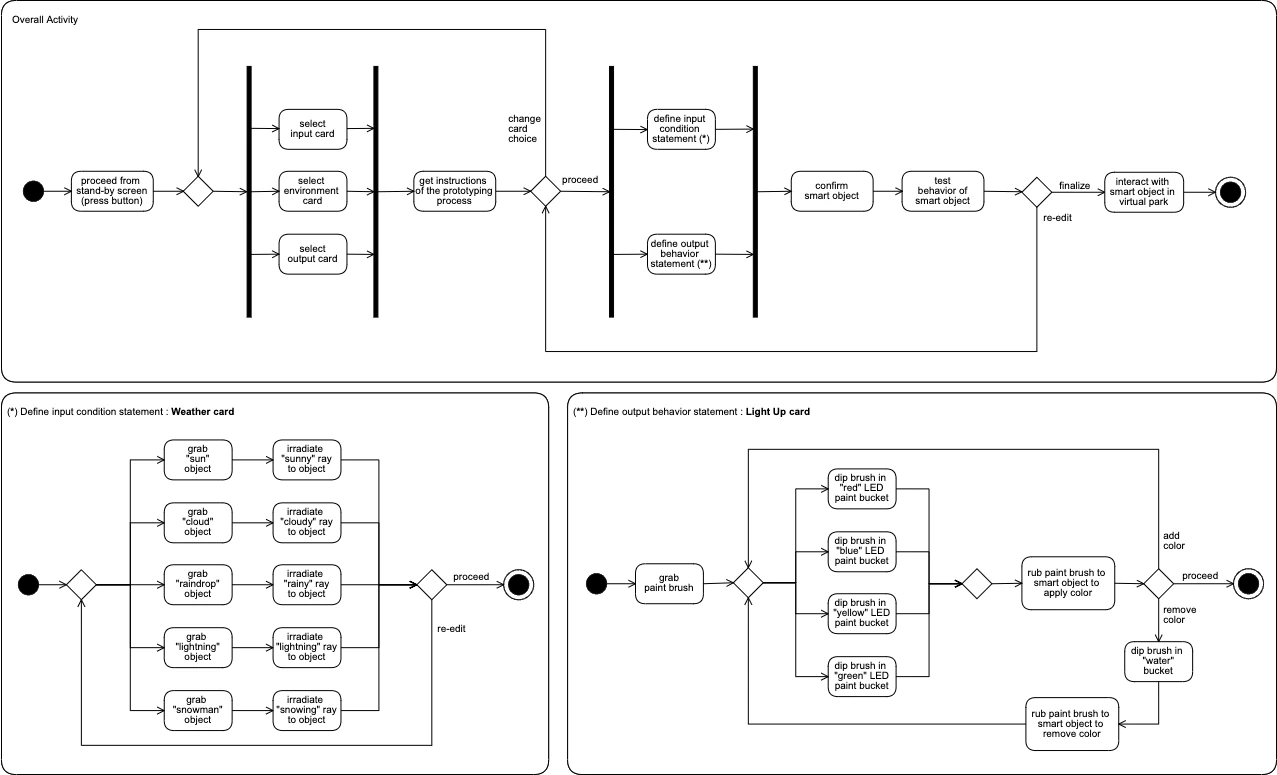
把以上内容整理成UML活动图,即下图所示。上段是整体流程,下段两幅分别把「天气预报」卡与「发光」卡的操作细致展开。选卡之后经指示可以退回重选,确定并试运行之后可以返回重新编辑,这些都各自写成了分支。
设备与工具
原型面向 Oculus Quest 2 开发。其六自由度追踪支持转身、移动和操控虚拟物件。由于反复动手交互是体验的核心,团队没有采用仅支持三自由度追踪的手机式头显。
游戏引擎为Unity,语言为C#;与Quest 2的连接使用Oculus Integration包,VR摄像机的行为、渲染与手柄输入的通用API都来自于它。
四个场景与13个类
系统按Unity的场景分为四个,正好对应体验的四个场景。类共13个,其中3个是抽象类。
标题场景只有TitleSceneCore,按下按钮即切换到下一场景。
卡片选择场景使用 CardSelectionSceneCore 和 CardSelectionDetector。CardSelectionSceneCore 创建三个 CardSelectionDetector 实例,分别对应环境、输入和输出选择箱。每个箱子会吸入附近的卡片物件,并将相应类别标记为已选择。三项选择完成后,场景将结果写入静态类 SmartObject,再切换到下一场景。SmartObject 在场景切换时保留这些数据,使四个场景构成连续的体验。
原型制作场景是核心。PrototypingSceneCore集中管理整个流程,卡片的行为则用以Card为顶点的继承层次来表示。Card之下是InputCard与OutputCard,再往下则排列着Weather、Fire、MakeSound、LightUp等具体卡片的类。真正承担原型制作操作的只有末端的具体类,因此上面这三个都做成了抽象类。
PrototypingSceneCore 分别维护输入条件实例列表和输出行为实例列表。如果选中“天气预报”和“发光”卡片,两个列表中分别保存 Weather 和 LightUp 实例。开始时各创建一个实例,之后每按一次添加按钮,就新增一对实例。系统每帧评估输入条件,并调用对应的输出行为。用户确认物件后,isConfirmed 被设为 true,组装好的行为数据会写入 SmartObject 的静态属性。
交互场景只包含 InteractionSceneCore 一个类,负责在公园中放置物件、测试已定义的条件与响应,以及最后的庆祝效果。
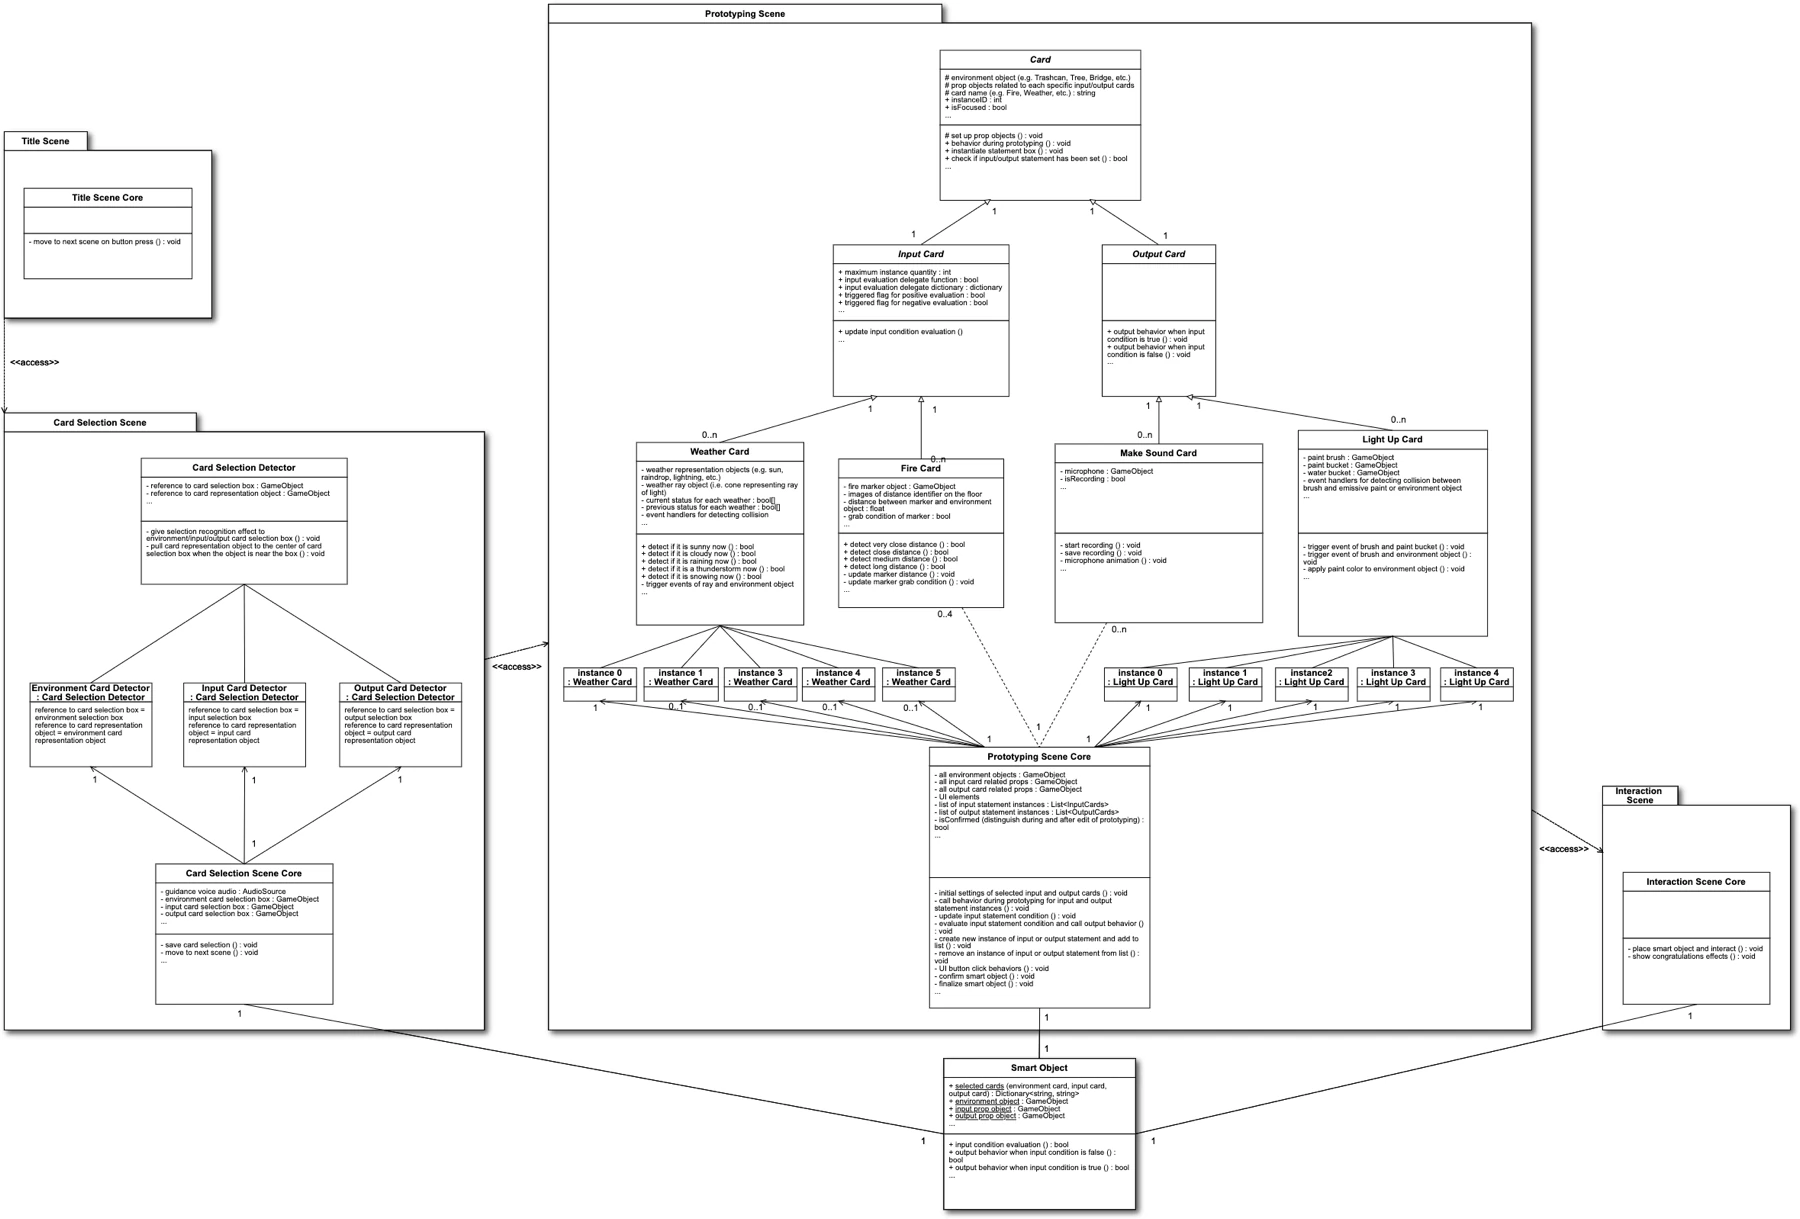
源代码可以从以下链接查看:
github.com/
成果与待完成的工作
已实现 49 张卡片中的 9 张
原型实现了 9 张卡片。核心功能已经能够运行:选择卡片、定义条件与行为、管理多个实例,以及在场景间传递数据。这为增加更多卡片提供了基础,但相关实现仍待完成。此外,6 张卡片已设计但未实现;其余 34 张还需要完成交互设计与实现。
| 状态 | 卡片 |
|---|---|
| 已实现(9张) | 环境:树、路灯、道路标志、垃圾桶、桥 输入:火、天气预报 输出:发出声音、发光 |
| 仅完成设计(6张) | 输入:按钮、速度、声音 输出:移动、振动、发送 |
| 尚未着手(34张) | 环境卡15张、输入卡16张、输出卡3张(显示、启动、记录) |
尚未开展用户评估
原型尚未经过用户评估。开发期间正值 COVID-19 疫情,团队以远程方式参与,既未能组织使用 VR 头显的线下工作坊,也未能安排远程替代方案。项目证明了所设计的体验能够实现为可运行原型,但儿童使用时的可用性,以及它在治疗场景中的价值,仍未经过检验。
未来评估将考察界面是否便于直观地制作原型。可能采用的指标包括完成时间、最终智能物件与参与者初始想法的吻合程度,以及误按按钮的次数。活动结束后,可用基于系统可用性量表(SUS)的问卷补充量化数据。后续评估也可在取得同意、遵循适当程序的前提下,录制活动以观察参与者的动作。2021 年项目曾将评估年龄设想为 13 岁,以兼顾 SNaP 的目标年龄与当时参考的 Oculus 指引。未来研究需要依据适用指引和研究方案,重新确定参与资格。
再往前的工作
进一步开发的首要任务是完善界面与使用体验。由于时间和经验有限,大部分精力投入了卡片组合功能,视觉、听觉与触觉设计仍不够完善。VR 中的文字使用也需要重新考虑:原本针对平面设计的信息,可能更适合通过空间用户界面(SUI)呈现。针对预期使用者,语音交互也是值得探索的方向。
项目提出了三个研究方向。第一,与 i3Lab 正在开发的实体板进行比较。既有研究报告称,参与者在虚拟环境中玩同一款协作游戏时,对话多于在实体环境中;这为比较两个平台提供了研究思路。第二,支持多名用户同时参与,让儿童能够像“Codesign”这一名称所表达的那样,在 VR 中共同搭建物件。第三,建立描述智能物件的标准化格式,使设计可以在不同平台之间迁移。
小结
本项目创建了制作智能物件原型的环境,将 SNaP 的三类卡片转化为组装单元:物件、触发条件和行为。玩家通过抓取、指向和涂抹把它们联系起来。这个可运行原型将文字构想转化为可交互的虚拟物件,其行为以数据形式表达,并可在场景间传递。
Takafumi Horiuchi, Paul Cozma-Ivan, Elmira Katsajeva, and Olivia Ludkiewicz,“Design and Implementation of a Smart Object Prototyping Platform in Virtual Reality for Children with NDD,” Advanced User Interfaces (A.Y. 2020–21) Final Exam Project,米兰理工大学,2021年2月。